Triton Çözümüyle Yapay Zeka Modellerinde Ölçeklenme ve Verimlilik
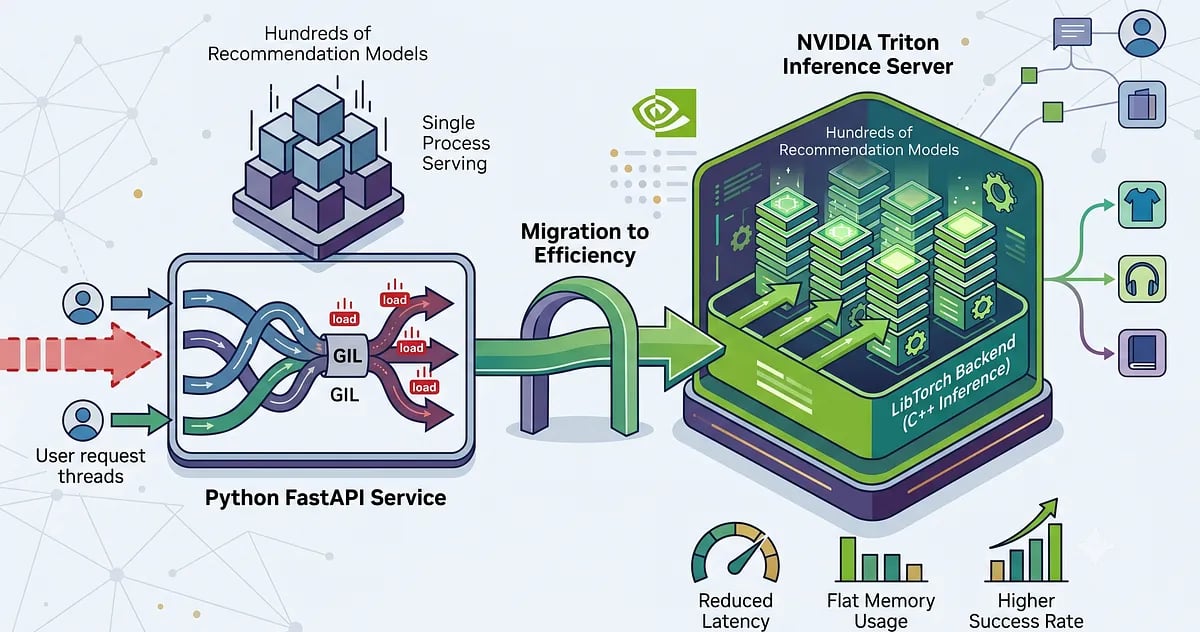
Bu makale, öneri sistemimizin üretim aşamasındaki model sunumunu geleneksel bir Python servisi mimarisinden NVIDIA'nın Triton Inference Server çözümü ile nasıl tamamen yeniden yapılandırdığımızı ele alıyor. Bu geçiş sırasında yapay zeka modelimizdeki herhangi bir değişiklik yapılmamıştır; değişen tek şey, o modeli işletme ve çalıştıran alt mekanizmadır.
İçerik boyunca eski kurulumumuzun sınırlılıklarını inceleyeceğiz, bizi bu devasa yeniliğe iten kritik sorunları öğrenecek ve nihayetinde yeni sistemin mimarisini nasıl kurduğumuzu analiz edeceğiz. Son olarak elde ettiğimiz performanstaki büyük artış rakamlarına bakacağız.
Eski Mimarideki Kullanıcı Etkileşimi Modeli Sorunları
Söz konusu olan model, biz kullanıcı etkileşim modeli adını verdiğimiz bir öneri sistemidir. Bu sekansiyel (sıralı) bir modeldir; kullanıcının yakın geçmişteki olaylarını —görüntüleme, sepetine ekleme veya satın alma gibi— sırasıyla analiz ederek bir sonraki en olası etkileşimi tahmin eder. Motor olarak XLNet tabanlı Transformer mimarisine dayanan bu modelin altyapısı oldukça karmaşıktır ve her iş ortağı (partner) kendi ürün kataloğu ve benzersiz kullanıcı davranışları nedeniyle ayrı bir model eğitimi alır.
Mevcut sistemimizde, gelen öneriler için model tüm partnerin kapsamındaki kalemler üzerinde olasılık dağılımı oluşturur. Ardından en yüksek puana sahip öğeleri seçerek bazı son işlem adımlarından geçirir ve nihai listeyi geri döneriz. Bazı iş ortakları binlerce ürüne sahipken, sistemimizin en büyük müşterileri milyonlarca ürünü barındırabilmektedir. Bu geniş çıktı alanı olası protokol sorunlarına neden olmaktadır.
Karşılaşılan Ölçeklendirme Engelleri
Başlangıçta bu karmaşık öneri modelini Kubernetes ortamında dağıtmıştık; Python tabanlı bir konteyner içinde Gunicorn ve birkaç Uvicorn işçi (worker) kullanarak çalışıyordu. Zamanla küçük ayarlar yaptık, ancak karşılaştığımız sorunlar basit bir yapılandırma değişikliğiyle çözülebilecek seviyede değildi.
İlk temel sorun, yeni modellerin pod'lara eklenmesiyle ortaya çıkan ani bellek yükselmeleriydi. Sürekli olarak bir veya birden fazla konteyner limitlerindeki belleği aşarak sistemden atılıyor ve buna OOM (Out Of Memory) deniyordu. Bu durum yükün diğer sağlıklı konteynerlere kaymasına ve bunlar da yetersiz kaldığında zincirleme sunucu çökmelerine yol açıyordu.
İkinci büyük sorun ise model servisine ait API'nin ölçeklenebilirlik eksikliğiydi. Model dosyalarını depolama alanından çekme süreci (S3 üzerinden birden fazla iş parçacığıyla yüklemek) yaklaşık iki dakika sürüyordu, bu da kullanıcı deneyiminde kabul edilemez bir gecikmeye neden oluyordu.
Son olarak model çalıştırma işlemi sırasında Python süreçlerinde oluşan hafıza sızıntıları (memory leak), sistemi yeniden başlatarak kısmen çözülse de mimari açıdan kalıcı bir çözüm sunmuyordu. Büyümeye devam ettiğimizde bu sorunlar, basit Gunicorn ayarlamalarıyla artık idare edilemez hale gelmişti.
Neden Triton ve Alternatifleri Neden Elimizden Çekti?
Bu ölçeklendirme zorlukları karşısında önümüzde iki ana seçenek vardı: Amazon SageMaker'ı kullanmak veya NVIDIA Triton Inference Server'a geçmek. Bu aralar SageMaker opsiyonunu bir kenara bıraktık. Bunun temel sebebi; elinde zaten kurulu, esnek ve açık kaynak çözümleri barındırabilecek güçlü bir Kubernetes kümesi bulunmasıydı. SageMaker ise karşılığında sunduğu kaynak miktarına kıyasla çok yüksek maliyet getiriyordu.
Triton'a odaklanmak, model yönetimini basitleştirir. Triton için modelleri belirlediğimiz formatta hazırlayıp bir depoya yüklememiz yeterliydi. Bizim kullandığımız yöntemde 'poll modu' (düzenli aralıklarla kontrol etme modu) sayesinde Triton otomatik olarak bu depodaki değişiklikleri fark ediyor, yeni modelleri yüklüyor veya sistemden kaldırılanları devre dışı bırakıyordu.
Model Katalog Yönetimi ve Delphin Entegrasyonu
Milyonlarca kullanıcı ve yüzlerce iş ortağıyla çalışırken hangi modelin ne zaman aktif olacağını yönetmek kritik bir süreçtir. Biz bu süreci, daha önce geliştirdiğimiz Delphi makine öğrenmesi platformundaki lokal ve uzaktan katalog fikirlerinden uyarladık. Redis, yani merkezi sunucu gibi tüm modellerin durumunu tutuyor; buna 'uzak katalog' diyoruz. İşçi (worker) konteynerleri ise her an ihtiyaç duyacağı modellerin bir kopyasını hafızasında hazır tutuyor ki 'lokal kataloğumuz' bu şekilde güncellensin.
Yeni mimaride, Triton artık modeli çalıştırma sorumluluğu üstlendiği için lokal ve uzaktan katalog yapısı model dosyalarını değil, arayüzün (gateway) hizmet verdiği gerekli sistem bileşenlerini takip ediyor. Redis hala tek veri kaynağı olarak hangi model tanımlarının sunulması gerektiğini belirtiyor. Ancak modellerin ağırlıkları artık doğrudan Triton tarafından yönetiliyor; Triton S3'teki model deposunu düzenli aralıklarla izleyerek yükleme ve devre dışı bırakma işlemlerini tamamen kendi iç mekanizmasıyla gerçekleştiriyor.